Redis
目录
数据结构
String Hash List Set SortedSet。
Redis内部存储结构
dictEntry
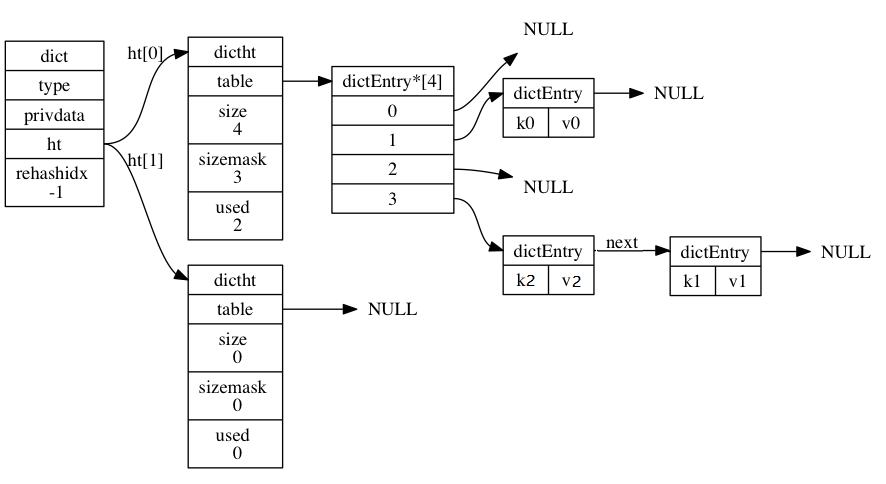
因为 Redis 是 KV 的数据库,它是通过 hashtable 实现的(我们把这个叫做外层的哈希)。
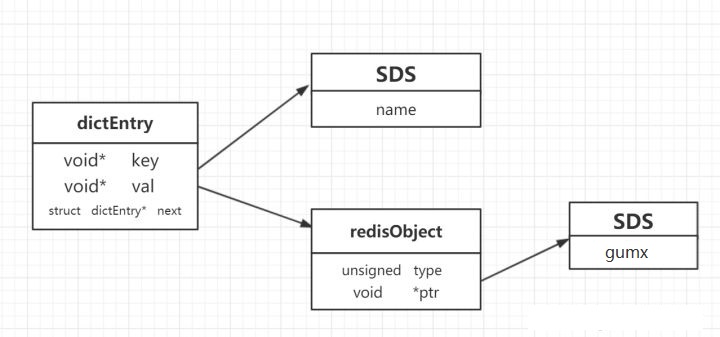
所以每个键值对都会有一个 dictEntry,里面指向了 key 和 value 的指针。next 指向下一个 dictEntry。源码如下:
typedef struct dictEntry {
    void *key;              //关键字
    union {
        void *val;
        uint64_t u64;
        int64_t s64;
        double d;
    } v;                    //val
    struct dictEntry *next; //next
} dictEntry;
key 是字符串,但是 Redis 没有直接使用 C 的字符数组,而是存储在自定义的 SDS中。
value 既不是直接作为字符串存储,也不是直接存储在 SDS 中,而是存储在redisObject 中。
实际上五种常用的数据类型的任何一种,都是通过 redisObject 来存储的。
typedef struct redisObject {
    unsigned type:4; /* 对象的类型, 包括: OBJ_STRING、 OBJ_LIST、 OBJ_HASH、 OBJ_SET、 OBJ_ZSET */
    unsigned encoding:4; /* 具体的数据结构 */
    unsigned lru:LRU_BITS; /* 24 位, 对象最后一次被命令程序访问的时间, 与内存回收有关 */
    int refcount; /* 引用计数。 当 refcount 为 0 的时候, 表示该对象已经不被任何对象引用, 则可以进行垃圾回收了*/
    void *ptr; /* 指向对象实际的数据结构 */
} robj;
String
sds是在Redis中被广泛使用的字符串结构,它的全称是Simple Dynamic String。与其它语言环境中出现的字符串相比,它具有如下显著的特点:
-
可动态扩展内存。sds表示的字符串其内容可以修改,也可以追加。在很多语言中字符串会分为mutable和immutable两种,显然sds属于mutable类型的。
-
二进制安全(Binary Safe)。sds能存储任意二进制数据,而不仅仅是可打印字符。
-
与传统的C语言字符串类型兼容。
Hash
ReHash
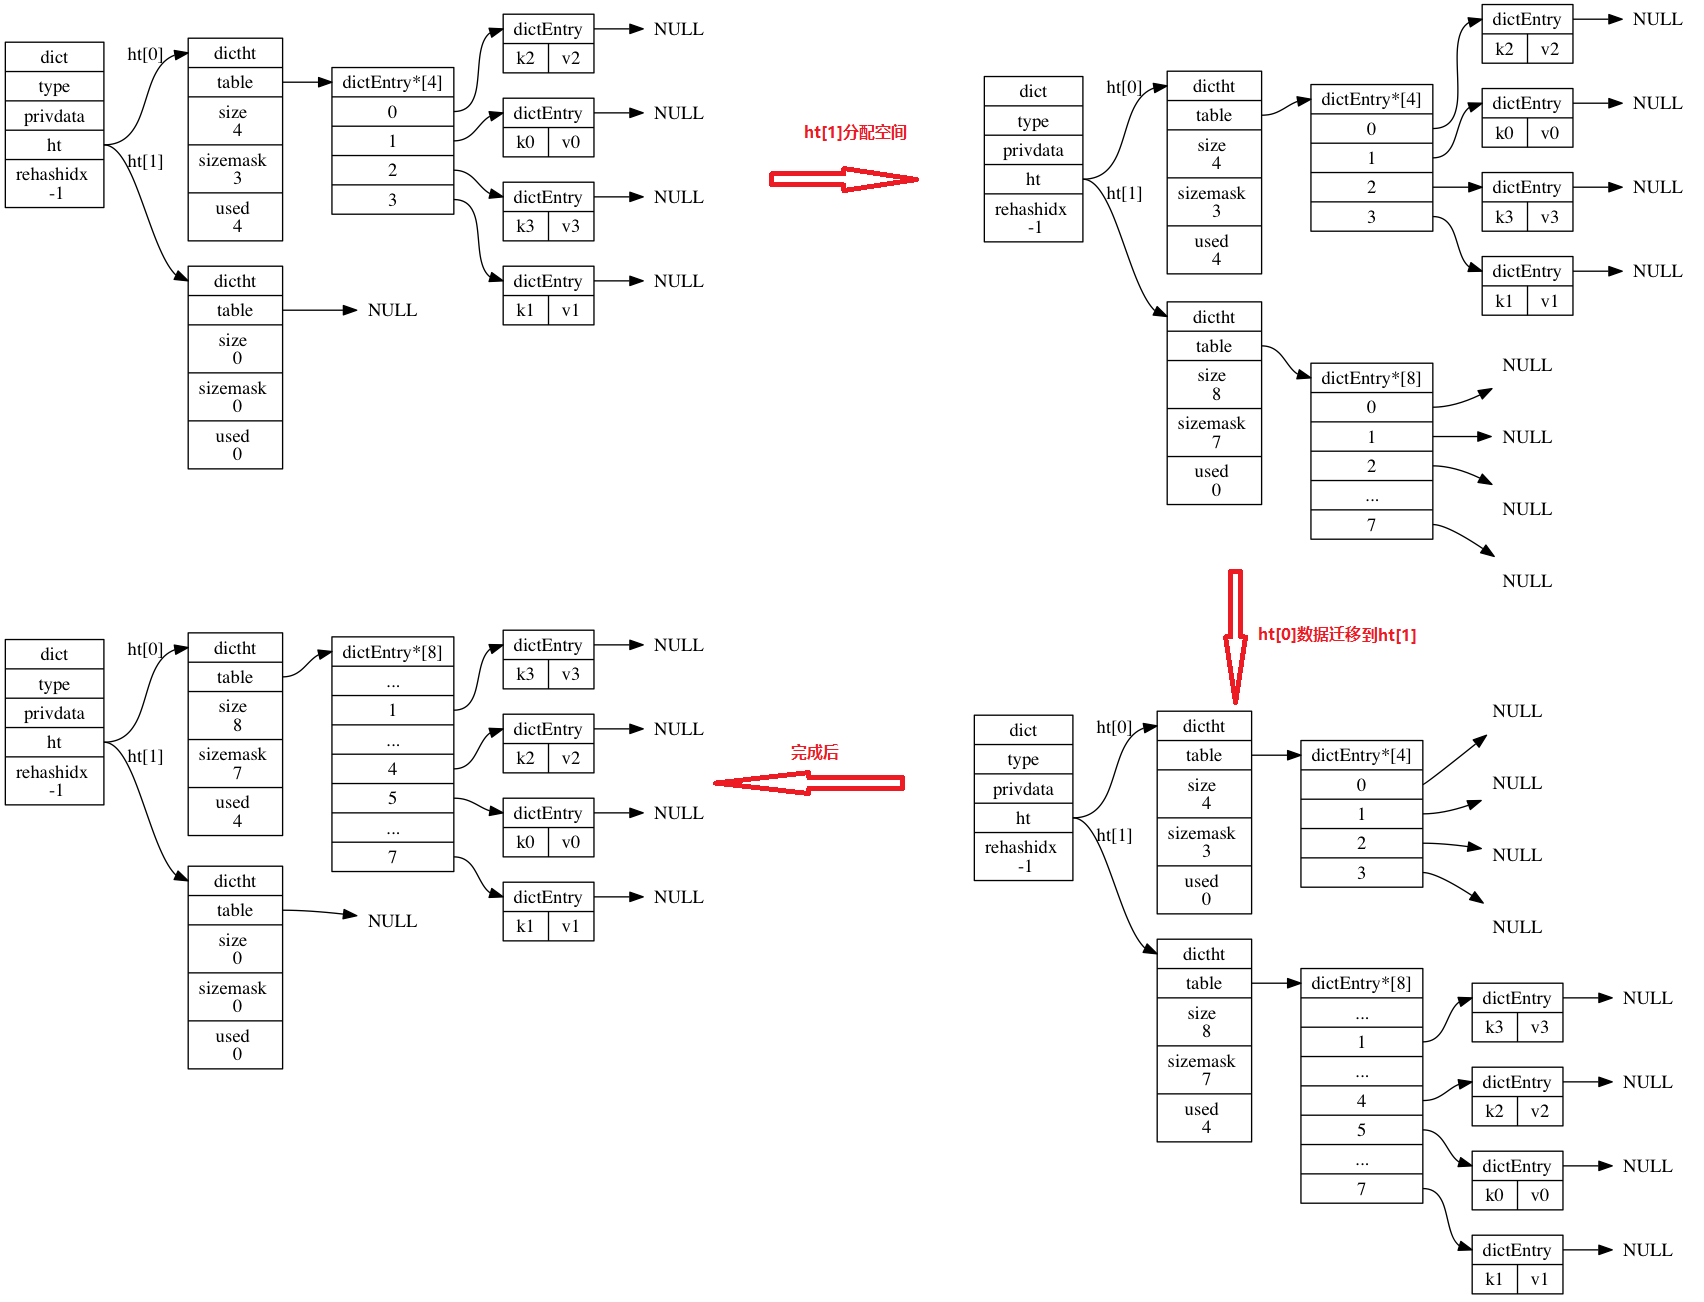
- 为ht[1] 分配空间,这个哈希表的空间大小取决于要执行的操作, 以及ht[0]当前包含的键值对数量 (也即是ht[0].used属性的值):
- 如果执行的是扩展操作, 那么 ht[1] 的大小为第一个大于等于 ht[0].used * 2 的 2^n (2 的 n 次方幂);
- 如果执行的是收缩操作, 那么 ht[1] 的大小为第一个大于等于 ht[0].used 的 2^n 。
- 将rehashidx 初始化为0 ,代表rehash 工作正式开始。
- 每次字典进行删除、查找、更新操作时, 会同时在两个hash表上进行(先查找ht[0], 如果没找到,再去查找ht[1])。 进行添加操作时,会直接添加到ht[1]。
- 在进行每次增删改查操作时, 会同时把ht[0] 在rehashidx 索引上的所有键值对都rehash到ht[1]上, 完成后 rehashidx 加1.
- 当ht[0] 所有元素都被复制到ht[1], 设置rehashidx 的值为-1 。
- 回收 ht[0],将 ht[1] 设置为 ht[0] , 并在 ht[1] 新创建一个空白哈希表, 为下一次 rehash 做准备。。
SkipList
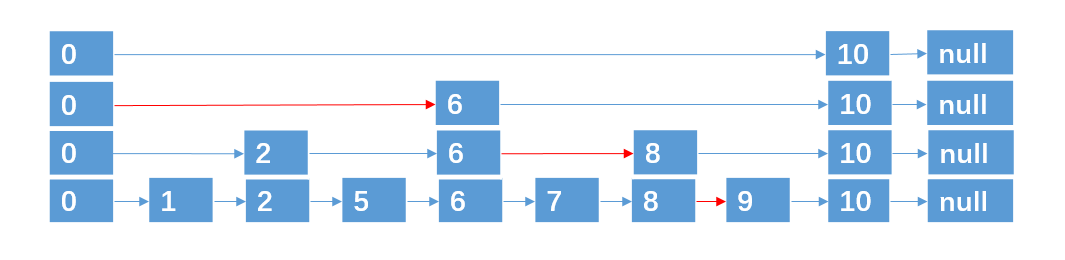
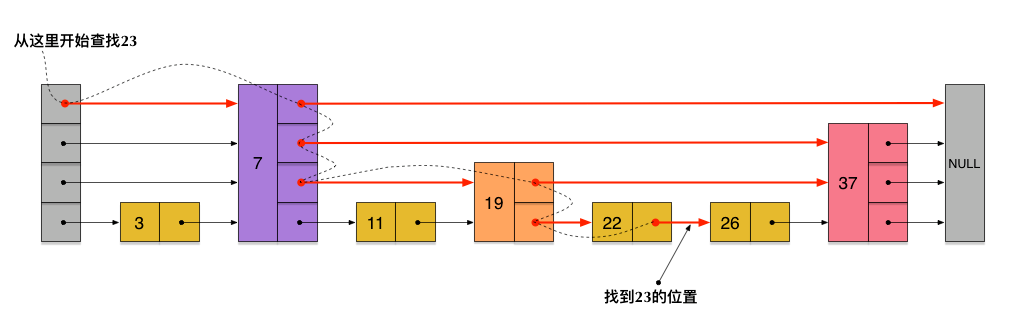
跳表不要求上下相邻两层链表之间的节点个数有严格的对应关系,而是为每个节点随机出一个层数(level)。
#define ZSKIPLIST_MAXLEVEL 32
#define ZSKIPLIST_P 0.25

int zslRandomLevel(void) {
    int level = 1;
    while ((random()&0xFFFF) < (ZSKIPLIST_P * 0xFFFF))
        level += 1;
    return (level<ZSKIPLIST_MAXLEVEL) ? level : ZSKIPLIST_MAXLEVEL;
}
执行插入操作时计算随机数的过程,是一个很关键的过程,它对skiplist的统计特性有着很重要的影响。
这并不是一个普通的服从均匀分布的随机数,而是服从一定规则的:
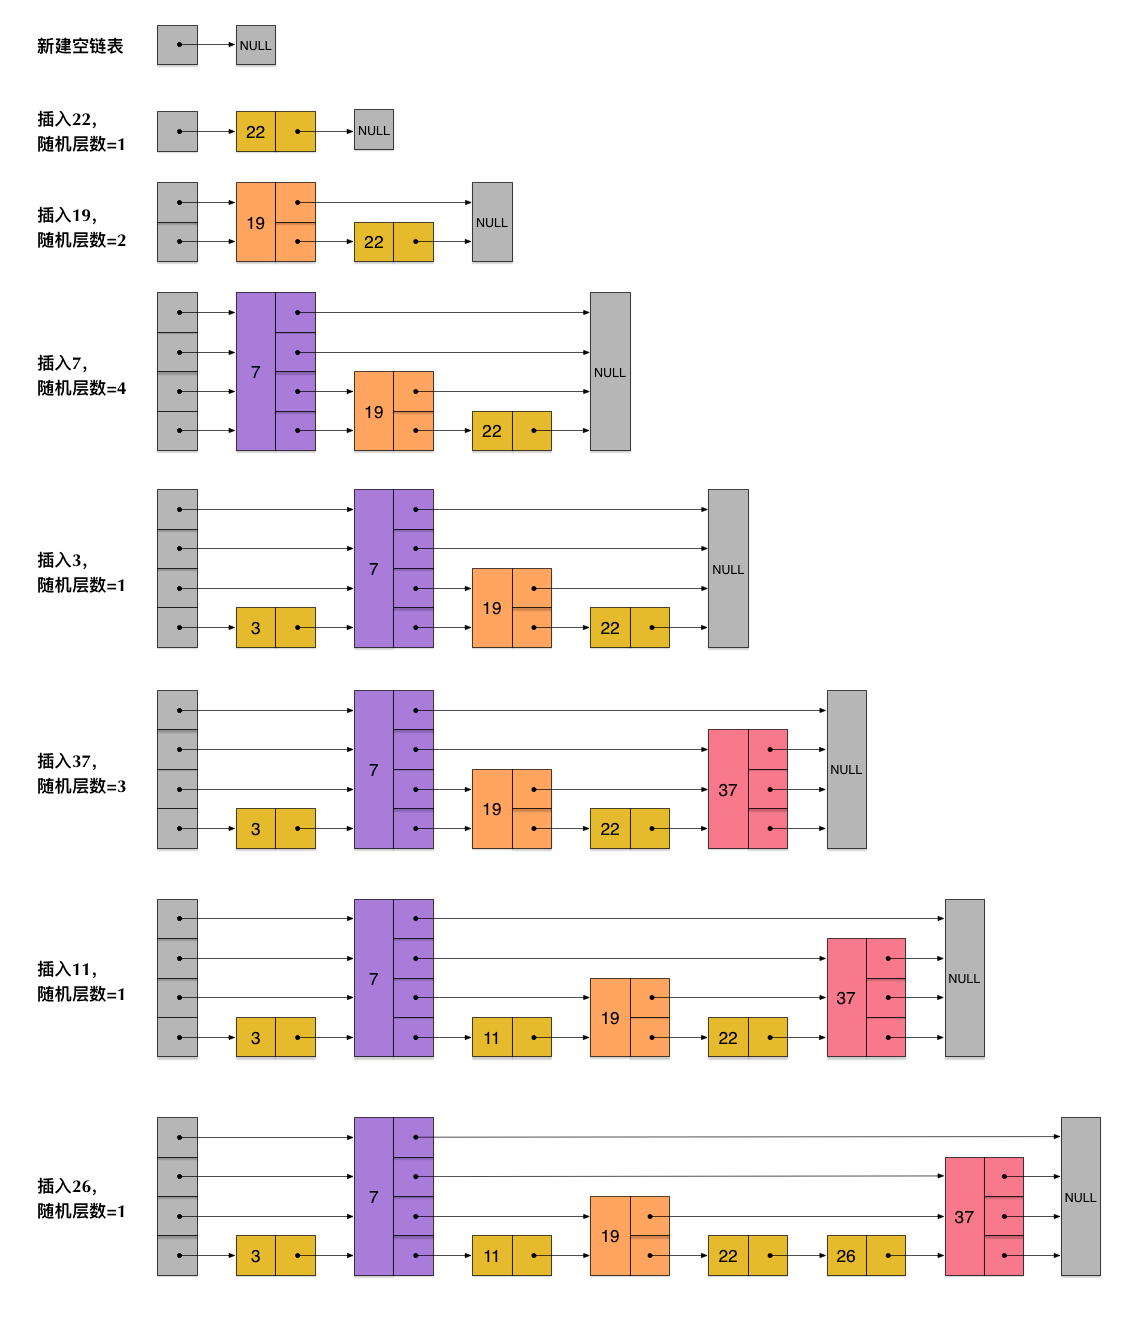
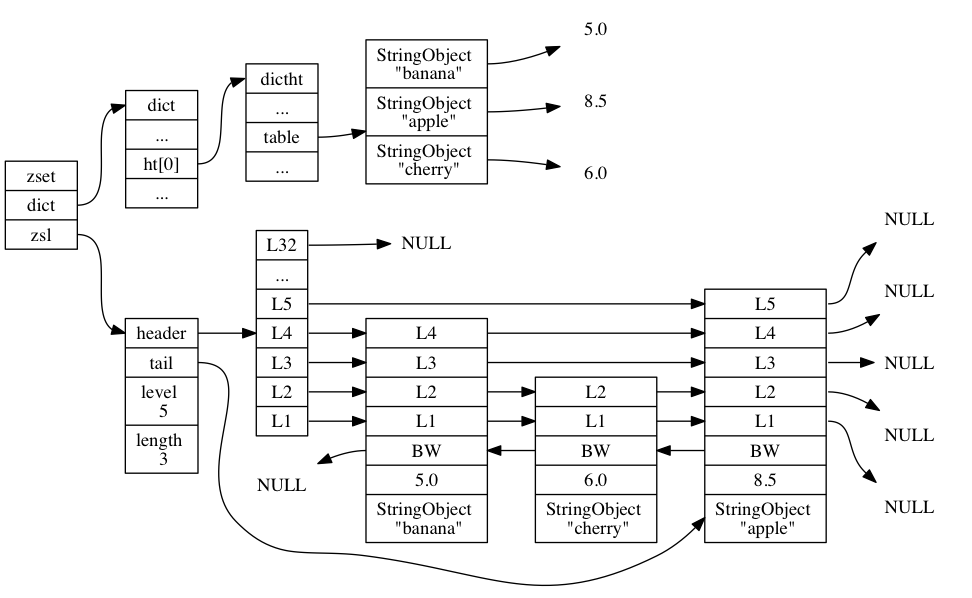
首先,每个节点肯定都有第1层指针(每个节点都在第1层链表里)。 如果一个节点有第i层(i>=1)指针(即节点已经在第1层到第i层链表中),那么它有第(i+1)层指针的概率为p。 节点最大的层数不允许超过一个最大值,记为MaxLevel(Redis里是32)。 比如,一个节点随机出的层数是3,那么就把它链入到第1层到第3层这三层链表中。
下图展示了如何通过一步步的插入操作从而形成一个skiplist的过程:
为什么跳表层数上限是32?
根据前面的随机算法当level[0]有2的64次方个节点时,才能达到32层,因此层数上限是32完全够用了。
为什么采用跳表,而不使用哈希表或平衡树实现
-
skiplist和各种平衡树(如AVL、红黑树等)的元素是有序排列的,而哈希表不是有序的。因此,在哈希表上只能做单个key的查找,不适宜做范围查找。所谓范围查找,指的是查找那些大小在指定的两个值之间的所有节点。
-
在做范围查找的时候,平衡树比skiplist操作要复杂。在平衡树上,我们找到指定范围的小值之后,还需要以中序遍历的顺序继续寻找其它不超过大值的节点。如果不对平衡树进行一定的改造,这里的中序遍历并不容易实现。而在skiplist上进行范围查找就非常简单,只需要在找到小值之后,对第1层链表进行若干步的遍历就可以实现。
-
平衡树的插入和删除操作可能引发子树的调整,逻辑复杂,而skiplist的插入和删除只需要修改相邻节点的指针,操作简单又快速。
-
从内存占用上来说,skiplist比平衡树更灵活一些。一般来说,平衡树每个节点包含2个指针(分别指向左右子树),而skiplist每个节点包含的指针数目平均为1/(1-p),具体取决于参数p的大小。如果像Redis里的实现一样,取p=1/4,那么平均每个节点包含1.33个指针,比平衡树更有优势。
高级数据结构
Bitmaps Hyperloglogs GEO
-
HyperLogLog是用于计算唯一事物的概率数据结构(从技术上讲,这被称为估计集合的基数)。 如果统计唯一项,项目越多,需要的内存就越多。因为需要记住过去已经看过的项,从而避免多次统计这些项。
-
GEO可以将用户给定的地理位置(经度和纬度)信息储存起来,并对这些信息进行操作
缓存
缓存穿透/击穿
- 查询一个数据库中不存在的数据,请求会越过Redis,直接请求DB。
做好防高频请求 非正常用户量的请求,10s内发起1000次请求 对于此请求的ip进行验证码校验,或者封禁处理
接口参数合法性校验 请求id需要>=0,分页每页最多100条等
将此key对应的value设置为一个默认的值,并设置相对短的失效时间例如30分钟
缓存雪崩
- 大量Key同时失效,又有大量请求同时到来,导致请求冲向DB,DB最终卡死。
处理缓存雪崩,在批量往Redis存数据的时候,把每个Key的失效时间都加个随机值,这样可以保证Key不会在同一时间大面积失效
热点缓存
- 某个Key过热,压力集中到一台Redis上
使用多级缓存机制,将过热的Key分散到各个服务器的本地缓存中,降低过热Key所在的Redis节点的压力,其他的Key依旧由分布式Redis集群承担
布隆过滤器(Bloom Filter)
概念
布隆过滤器可以用于检索一个元素是否在一个集合中。它的优点是空间效率和查询时间都远远超过一般的算法,缺点是有一定的误识别率和删除困难。
原理
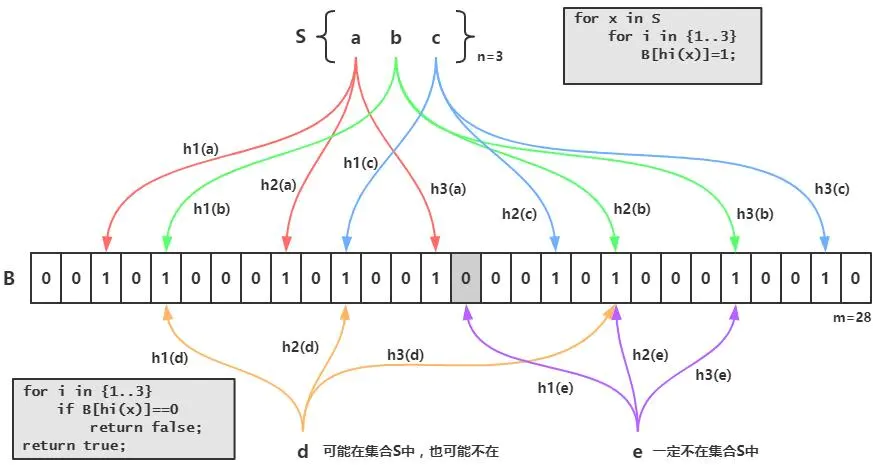
布隆过滤器的原理是,当一个元素被加入集合时,通过K个散列函数将这个元素映射成一个位数组中的K个点,把它们置为1。
检索时,我们只要看看这些点是不是都是1就(大约)知道集合中有没有它了
如果这些点有任何一个0,则被检元素一定不在
如果都是1,则被检元素很可能在。这就是布隆过滤器的基本思想。
Bloom Filter跟单哈希函数Bit-Map不同之处在于:Bloom Filter使用了k个哈希函数,每个字符串跟k个bit对应。从而降低了冲突的概率。
缺点
bloom filter之所以能做到在时间和空间上的效率比较高,是因为牺牲了判断的准确率、删除的便利性
-
存在误判,可能要查到的元素并没有在容器中,但是hash之后得到的k个位置上值都是1。如果bloom filter中存储的是黑名单,那么可以通过建立一个白名单来存储可能会误判的元素。
-
删除困难。一个放入容器的元素映射到bit数组的k个位置上是1,删除的时候不能简单的直接置为0,可能会影响其他元素的判断。可以采用Counting Bloom Filter
分布式锁
为什么要用分布式锁
- Efficiency(效率) 在分布式系统中,避免不同节点重复做相同的工作,节约计算机资源。
- Correctness(正确) 避免不同节点并发处理同一段数据时,相互干扰结果。例如对一个订单同时进行不同流程,最终订单状态出现混乱
简单的分布式锁实现
单节点Redis
简单实现,可以使用 SET key value PX milliseoncds NX
这个方案会引申出两个问题
-
锁从master复制到slave的时候挂了,会出现同一资源被多个client加锁。
-
执行时间超过了锁的过期时间。很难保证任务一定能在锁的过期时间内完成。
RedLock
Redlock算法是Antirez在单Redis节点基础上引入的高可用模式。
在Redis的分布式环境中,我们假设有N个完全互相独立的Redis节点,在N个Redis实例上使用与在Redis单实例下相同方法获取锁和释放锁。
现在假设有5个Redis主节点(大于3的奇数个),这样基本保证他们不会同时都宕掉。
获取锁和释放锁的过程中,客户端会执行以下操作:
1.获取当前Unix时间,以毫秒为单位
2.依次尝试从5个实例,使用相同的key和具有唯一性的value获取锁当向Redis请求获取锁时,客户端应该设置一个网络连接和响应超时时间,这个超时时间应该小于锁的失效时间,这样可以避免客户端死等
3.客户端使用当前时间减去开始获取锁时间就得到获取锁使用的时间。当且仅当从半数以上的Redis节点取到锁,并且使用的时间小于锁失效时间时,锁才算获取成功
4.如果取到了锁,key的真正有效时间等于有效时间减去获取锁所使用的时间,这个很重要
5.如果因为某些原因,获取锁失败(没有在半数以上实例取到锁或者取锁时间已经超过了有效时间),客户端应该在所有的Redis实例上进行解锁,无论Redis实例是否加锁成功,因为可能服务端响应消息丢失了但是实际成功了,毕竟多释放一次也不会有问题
个人想法
能不用分布式锁就不用分布式锁,避免引入新的复杂度,对于需要使用锁的场景,优先基于中间件原子性的机制操作。
MySQL数据库,加上version字段,强制要求所有update语句带上set version=version+1 where version={old_version}
可能重复insert的场景,对合理的业务id加上唯一索引,由数据库自有机制保证不会有重复数据插入
秒杀,统计等场景,使用Redis的incr,decr语句来替代分布式锁操作库存
持久化
-
RDB 持久化可以在指定的时间间隔内生成数据集的时间点快照(point-in-time snapshot)。(适合冷备)
-
AOF 持久化记录服务器执行的所有写操作命令,并在服务器启动时,通过重新执行这些命令来还原数据集。 AOF 文件中的命令全部以 Redis 协议的格式来保存,新命令会被追加到文件的末尾。(适合热备)
Redis 还可以在后台对 AOF 文件进行重写(rewrite),使得 AOF 文件的体积不会超出保存数据集状态所需的实际大小。
Redis 还可以同时使用 AOF 持久化和 RDB 持久化。 在这种情况下, 当 Redis 重启时, 它会优先使用 AOF 文件来还原数据集, 因为 AOF 文件保存的数据集通常比 RDB 文件所保存的数据集更完整。
但实际上持久化会对Redis的性能造成非常严重的影响,如果一定需要保存数据,那么数据就不应该依靠缓存来保存,建议使用其他方式如数据库。所以Redis的持久化意义不大。
RDB优缺点
- 优点:
他会生成多个数据文件,每个数据文件分别都代表了某一时刻Redis里面的数据,这种方式,适合做冷备。
RDB对Redis的性能影响非常小,是因为在同步数据的时候他只是fork了一个子进程去做持久化的,而且他在数据恢复的时候速度比AOF来的快。
- 缺点:
RDB都是快照文件,都是默认五分钟甚至更久的时间才会生成一次,这意味着你这次同步到下次同步这中间五分钟的数据都很可能全部丢失掉。
RDB在生成数据快照的时候,如果文件很大,客户端可能会暂停几毫秒甚至几秒。
AOF优缺点
- 优点:
RDB五分钟一次生成快照,但是AOF是一秒一次去通过一个后台的线程fsync操作,那最多丢这一秒的数据。
AOF在对日志文件进行操作的时候是以append-only的方式去写的,他只是追加的方式写数据,自然就少了很多磁盘寻址的开销了,写入性能惊人,文件也不容易破损。
AOF的日志是通过一个叫非常可读的方式记录的,这样的特性就适合做灾难性数据误删除的紧急恢复了,比如公司的实习生通过flushall清空了所有的数据,只要这个时候后台重写还没发生,你马上拷贝一份AOF日志文件,把最后一条flushall命令删了就完事了。
- 缺点:
一样的数据,AOF文件比RDB还要大。
AOF开启后,Redis支持写的QPS会比RDB支持写的要低。
同步机制
Redis可以使用主从同步,从从同步。
第一次同步时,主节点做一次bgsave,并同时将后续修改操作记录到内存buffer,待完成后将RDB文件全量同步到复制节点,复制节点接受完成后将RDB镜像加载到内存。
加载完成后,再通知主节点将期间修改的操作记录同步到复制节点进行重放就完成了同步过程。
后续的增量数据通过AOF日志同步即可,有点类似数据库的binlog。
高可用/集群
Redis Sentinal 着眼于高可用,在master宕机时会自动将slave提升为master,继续提供服务。
Redis Cluster 着眼于扩展性,在单个redis内存不足时,使用Cluster进行分片存储。
Gossip协议
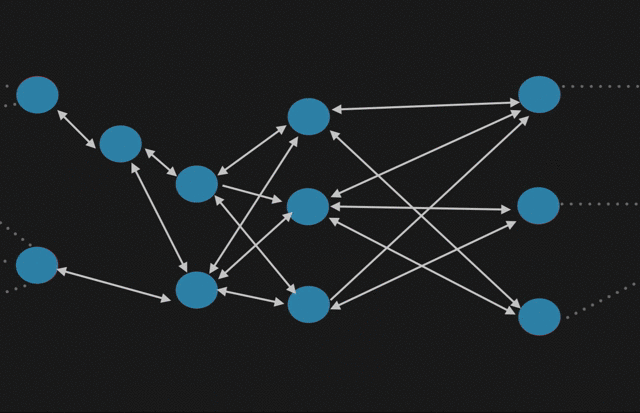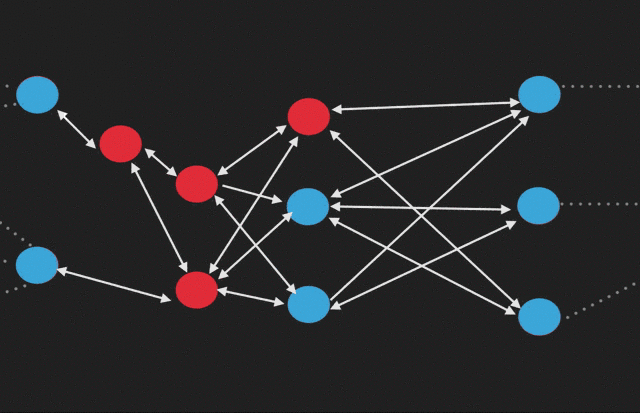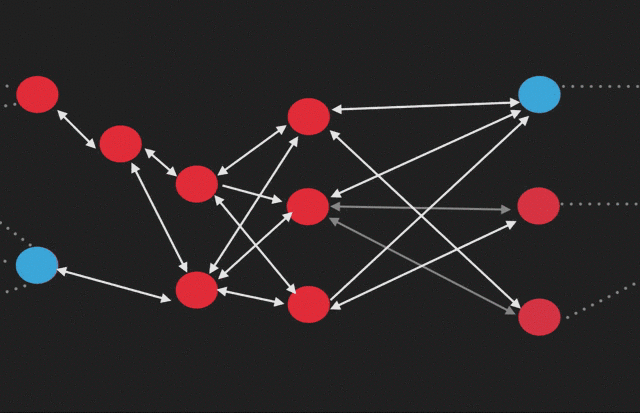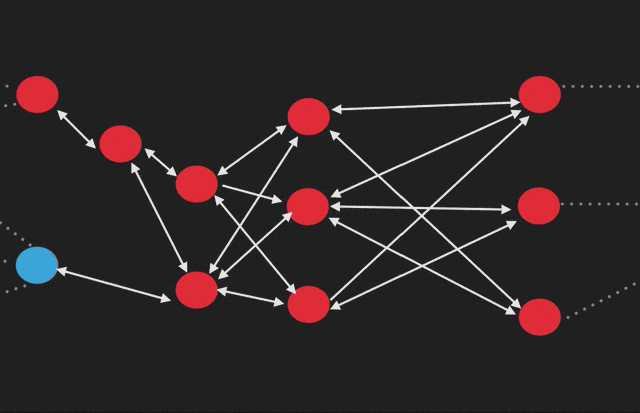
Gossip算法又被称为反熵(Anti-Entropy),熵是物理学上的一个概念,代表杂乱无章,而反熵就是在杂乱无章中寻求一致
这充分说明了Gossip的特点:在一个有界网络中,每个节点都随机地与其他节点通信,经过一番杂乱无章的通信,最终所有节点的状态都会达成一致。
每个节点可能知道所有其他节点,也可能仅知道几个邻居节点,只要这些节可以通过网络连通,最终他们的状态都是一致的
Redis Gossip消息分为消息头和消息体,消息体一共有4类,其中MEET、PING和PONG消息都用clusterMsgDataGossip结构来表示。
随机周期性发送PING消息
Redis的分片机制
Redis 集群没有使用一致性hash, 而是引入了哈希槽的概念。
Redis Cluster 采用虚拟哈希槽分区,所有的键根据哈希函数映射到 0 ~ 16383 整数槽内,每个key通过CRC16校验后对16384取模来决定放置哪个槽(Slot),每一个节点负责维护一部分槽以及槽所映射的键值数据。
计算公式:slot = CRC16(key) & 16383。
这种结构很容易添加或者删除节点,并且无论是添加删除或者修改某一个节点,都不会造成集群不可用的状态。使用哈希槽的好处就在于可以方便的添加或移除节点。
当需要增加节点时,只需要把其他节点的某些哈希槽挪到新节点就可以了;
当需要移除节点时,只需要把移除节点上的哈希槽挪到其他节点就行了。
为什么RedisCluster会设计成16384个槽呢?
1.如果槽位为65536,发送心跳信息的消息头达8k,发送的心跳包过于庞大。
如上所述,在消息头中,最占空间的是 slots[CLUSTER_SLOTS/8]。 当槽位为65536时,这块的大小是: 65536÷8÷1024=8kb因为每秒钟,redis节点需要发送一定数量的ping消息作为心跳包,如果槽位为65536,这个ping消息的消息头太大了,浪费带宽。
2.redis的集群主节点数量基本不可能超过1000个。
如上所述,集群节点越多,心跳包的消息体内携带的数据越多。如果节点过1000个,也会导致网络拥堵。因此redis作者,不建议redis cluster节点数量超过1000个。 那么,对于节点数在1000以内的redis cluster集群,16384个槽位够用了。没有必要拓展到65536个。
3.槽位越小,节点少的情况下,压缩率高
Redis主节点的配置信息中,它所负责的哈希槽是通过一张bitmap的形式来保存的,在传输过程中,会对bitmap进行压缩,但是如果bitmap的填充率slots / N很高的话(N表示节点数),bitmap的压缩率就很低。 如果节点数很少,而哈希槽数量很多的话,bitmap的压缩率就很低。
Redis数据增多了,是该加内存还是加实例?
这跟 Redis 的持久化机制有关系。
在使用 RDB 进行持久化时,Redis 会 fork 子进程来完成,fork 操作的用时和 Redis 的数据量是正相关的,而 fork 在执行时会阻塞主线程。
数据量越大,fork 操作造成的主线程阻塞的时间越长。所以,在使用 RDB 对 25GB 的数据进行持久化时,数据量较大,后台运行的子进程在 fork 创建时阻塞了主线程,于是就导致 Redis 响应变慢了。
集群脑裂
min-replicas-to-write 3
min-replicas-max-lag 10
要求至少3个slave节点,且数据复制和同步的延迟不能超过10秒。否则master就拒绝读写,这样发生集群脑裂原先的master节点接收到写入请求就会拒绝
Raft协议解决脑裂
选举安全性,即在一个任期内最多一个领导人被选出,如果有多余的领导人被选出,则被称为脑裂(brain split),如果出现脑裂会导致数据的丢失或者覆盖。
Raft通过下面两点保证了不会出现脑裂的情况;
- 一个节点某一任期内最多只能投一票;
- 只有获得大多数选票才能成为领导人;
通过增加约束避免了脑裂的情况出现,保证了同一时间集群中只有一个领导者。
但是当一个节点崩溃了一段时间,他的状态机已经落后其他节点很多,突然他重启恢复被选举为领导者,这个时候,客户端发来的请求再经由他复制给其他节点的状态机执行,就会出现集群状态机状态不一致的问题。
参考
漫谈Gossip协议与其在Redis Cluster中的实现