TCP/IP
目录
TCP 头格式
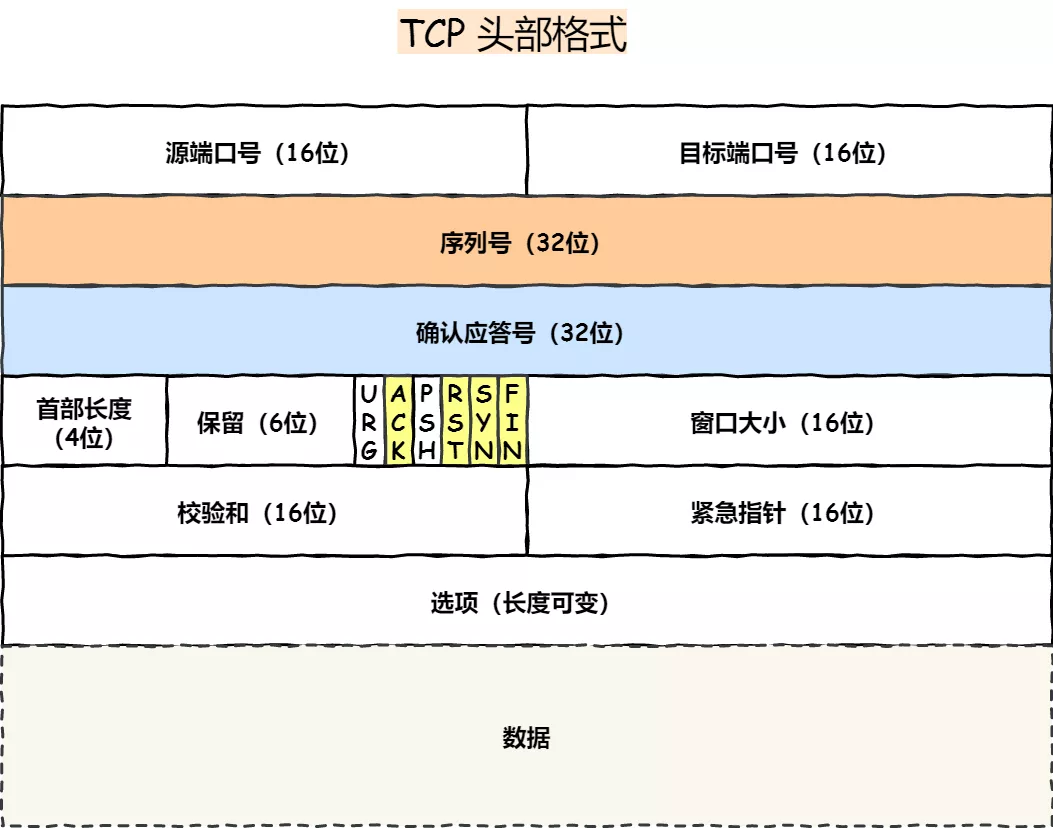
序列号:在建立连接时由计算机生成的随机数作为其初始值,通过 SYN 包传给接收端主机,每发送一次数据,就「累加」一次该「数据字节数」的大小。用来解决网络包乱序问题。
确认应答号:指下一次「期望」收到的数据的序列号,发送端收到这个确认应答以后可以认为在这个序号以前的数据都已经被正常接收。用来解决不丢包的问题。
控制位:
-
ACK:该位为 1 时,「确认应答」的字段变为有效,TCP 规定除了最初建立连接时的 SYN 包之外该位必须设置为 1 。
-
RST:该位为 1 时,表示 TCP 连接中出现异常必须强制断开连接。
-
SYC:该位为 1 时,表示希望建立连,并在其「序列号」的字段进行序列号初始值的设定。
-
FIN:该位为 1 时,表示今后不会再有数据发送,希望断开连接。当通信结束希望断开连接时,通信双方的主机之间就可以相互交换 FIN 位置为 1 的 TCP 段。
TCP 工作在哪一层
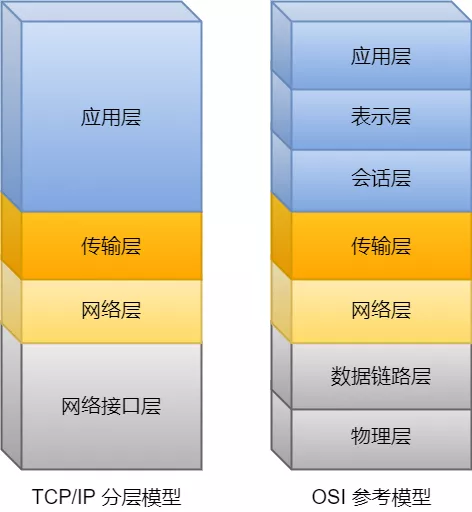
IP 层(网络层)是「不可靠」的,它不保证网络包的交付、不保证网络包的按序交付、也不保证网络包中的数据的完整性。
如果需要保障网络数据包的可靠性,那么就需要由上层(传输层)的 TCP 协议来负责。
因为 TCP 是一个工作在传输层的可靠数据传输的服务,它能确保接收端接收的网络包是无损坏、无间隔、非冗余和按序的。
什么是 TCP 连接
我们来看看 RFC 793 是如何定义「连接」的:
Connections:
The reliability and flow control mechanisms described above require that TCPs initialize and maintain certain status information for each data stream.
The combination of this information, including sockets, sequence numbers, and window sizes, is called a connection.
简单来说就是,用于保证可靠性和流量控制维护的某些状态信息,这些信息的组合,包括Socket、序列号和窗口大小称为连接。
- Socket:由 IP 地址和端口号组成
- 序列号:用来解决乱序问题等
- 窗口大小:用来做流量控制
如何唯一确定一个 TCP 连接
TCP 四元组可以唯一的确定一个连接,四元组包括如下:
-
源地址
-
源端口
-
目的地址
-
目的端口
源地址和目的地址的字段(32位)是在 IP 头部中,作用是通过 IP 协议发送报文给对方主机。
源端口和目的端口的字段(16位)是在 TCP 头部中,作用是告诉 TCP 协议应该把报文发给哪个进程。
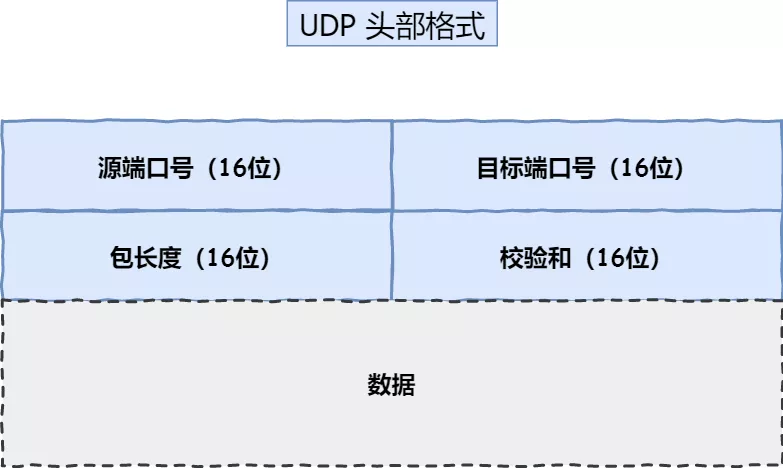
UDP 头格式
UDP 不提供复杂的控制机制,利用 IP 提供面向「无连接」的通信服务。
UDP 协议真的非常简,头部只有 8 个字节( 64 位),UDP 的头部格式如下
TCP UDP 区别
- 连接
TCP 是面向连接的传输层协议,传输数据前先要建立连接。
UDP 是不需要连接,即刻传输数据。
- 服务对象
TCP 是一对一的两点服务,即一条连接只有两个端点。
UDP 支持一对一、一对多、多对多的交互通信
- 可靠性
TCP 是可靠交付数据的,数据可以无差错、不丢失、不重复、按需到达。
UDP 是尽最大努力交付,不保证可靠交付数据。
- 拥塞控制、流量控制
TCP 有拥塞控制和流量控制机制,保证数据传输的安全性。
UDP 则没有,即使网络非常拥堵了,也不会影响 UDP 的发送速率。
- 首部开销
TCP 首部长度较长,会有一定的开销,首部在没有使用「选项」字段时是 20 个字节,如果使用了「选项」字段则会变长的。
UDP 首部只有 8 个字节,并且是固定不变的,开销较小。
TCP 和 UDP 应用场景:
由于 TCP 是面向连接,能保证数据的可靠性交付,因此经常用于:
-
FTP 文件传输
-
HTTP / HTTPS
由于 UDP 面向无连接,它可以随时发送数据,再加上UDP本身的处理既简单又高效,因此经常用于:
-
包总量较少的通信,如 DNS 、SNMP 等
-
视频、音频等多媒体通信
-
广播通信
TCP 三次握手过程和状态变迁
TCP 是面向连接的协议,所以使用 TCP 前必须先建立连接,而建立连接是通过三次握手而进行的。
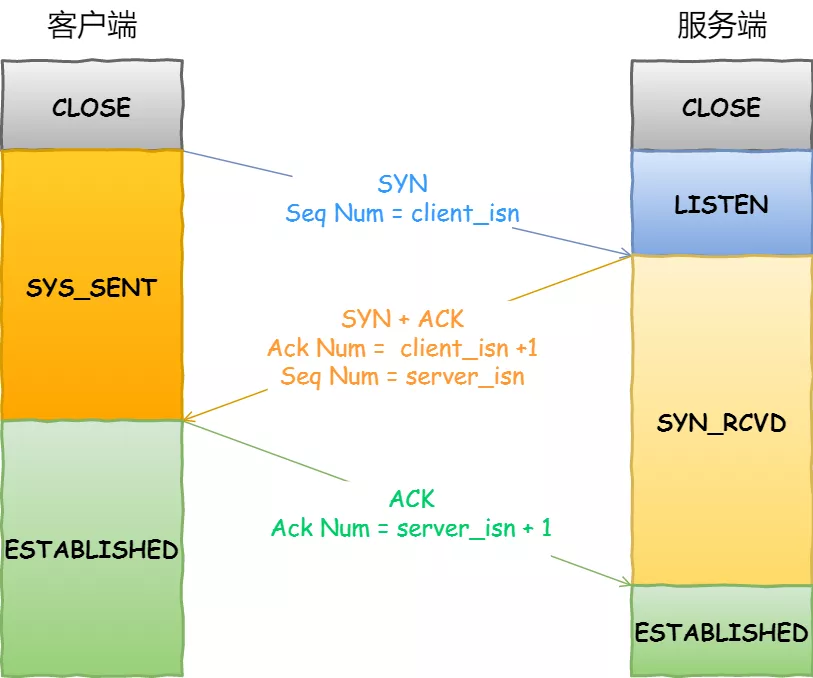
一开始,客户端和服务端都处于 CLOSED 状态。先是服务端主动监听某个端口,处于 LISTEN 状态
客户端会随机初始化序号(client_isn),将此序号置于 TCP 首部的「序号」字段中,同时把 SYN 标志位置为 1 ,表示 SYN 报文。接着把第一个 SYN 报文发送给服务端,表示向服务端发起连接,该报文不包含应用层数据,之后客户端处于 SYN-SENT 状态。
服务端收到客户端的 SYN 报文后,首先服务端也随机初始化自己的序号(server_isn),将此序号填入 TCP 首部的「序号」字段中,其次把 TCP 首部的「确认应答号」字段填入 client_isn + 1, 接着把 SYN 和 ACK 标志位置为 1。最后把该报文发给客户端,该报文也不包含应用层数据,之后服务端处于 SYN-RCVD 状态。
客户端收到服务端报文后,还要向服务端回应最后一个应答报文,首先该应答报文 TCP 首部 ACK 标志位置为 1 ,其次「确认应答号」字段填入 server_isn + 1 ,最后把报文发送给服务端,这次报文可以携带客户到服务器的数据,之后客户端处于 ESTABLISHED 状态。
服务器收到客户端的应答报文后,也进入 ESTABLISHED 状态。
为什么三次握手才可以建立连接
以三个方面分析三次握手的原因:
-
三次握手才可以阻止历史重复连接的初始化(主要原因)
-
三次握手才可以同步双方的初始序列号
-
三次握手才可以避免资源浪费
原因一:避免历史连接
我们来看看 RFC 793 指出的 TCP 连接使用三次握手的首要原因:
The principle reason for the three-way handshake is to prevent old duplicate connection initiations from causing confusion.
简单来说,三次握手的首要原因是为了防止旧的重复连接初始化造成混乱。
网络环境是错综复杂的,往往并不是如我们期望的一样,先发送的数据包,就先到达目标主机,反而它很骚,可能会由于网络拥堵等乱七八糟的原因,会使得旧的数据包,先到达目标主机,那么这种情况下 TCP 三次握手是如何避免的呢?
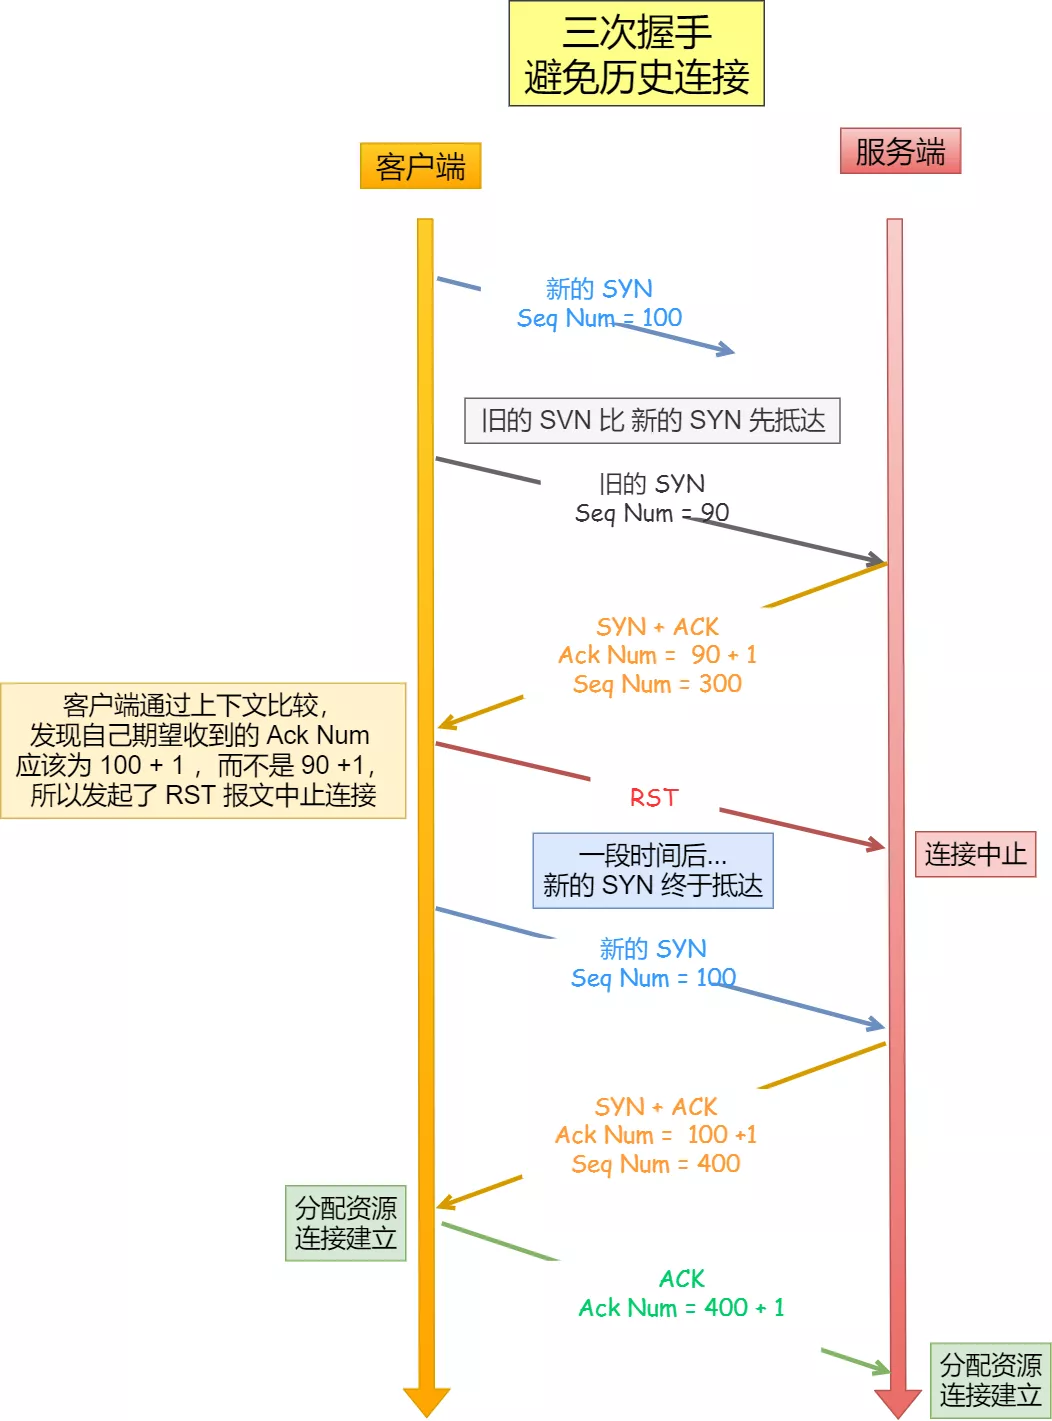
客户端连续发送多次 SYN 建立连接的报文,在网络拥堵等情况下:
-
一个「旧 SYN 报文」比「最新的 SYN 」 报文早到达了服务端;
-
那么此时服务端就会回一个 SYN + ACK 报文给客户端;
-
客户端收到后可以根据自身的上下文,判断这是一个历史连接(序列号过期或超时),那么客户端就会发送 RST 报文给服务端,表示中止这一次连接。
如果是两次握手连接,就不能判断当前连接是否是历史连接,三次握手则可以在客户端(发送方)准备发送第三次报文时,客户端因有足够的上下文来判断当前连接是否是历史连接:
-
如果是历史连接(序列号过期或超时),则第三次握手发送的报文是 RST 报文,以此中止历史连接;
-
如果不是历史连接,则第三次发送的报文是 ACK 报文,通信双方就会成功建立连接;
所以, TCP 使用三次握手建立连接的最主要原因是 防止历史连接初始化了连接。
原因二:同步双方初始序列号
TCP 协议的通信双方, 都必须维护一个「序列号」, 序列号是可靠传输的一个关键因素,它的作用:
接收方可以去除重复的数据;
接收方可以根据数据包的序列号按序接收;
可以标识发送出去的数据包中, 哪些是已经被对方收到的;
可见,序列号在 TCP 连接中占据着非常重要的作用,所以当客户端发送携带「初始序列号」的 SYN 报文的时候,需要服务端回一个 ACK 应答报文, 表示客户端的 SYN 报文已被服务端成功接收,那当服务端发送「初始序列号」给客户端的时候,依然也要得到客户端的应答回应, 这样一来一回,才能 确保双方的初始序列号能被可靠的同步。
而两次握手只保证了一方的初始序列号能被对方成功接收,没办法保证双方的初始序列号都能被确认接收。
原因三:避免资源浪费
如果只有「两次握手」,当客户端的 SYN 请求连接在网络中阻塞,客户端没有接收到 ACK 报文,就会重新发送 SYN ,由于没有第三次握手,服务器不清楚客户端是否收到了自己发送的建立连接的 ACK 确认信号,所以每收到一个 SYN 就只能先主动建立一个连接,这会造成什么情况呢?
如果客户端的 SYN 阻塞了,重复发送多次 SYN 报文,那么服务器在收到请求后就会 建立多个冗余的无效链接,造成不必要的资源浪费。
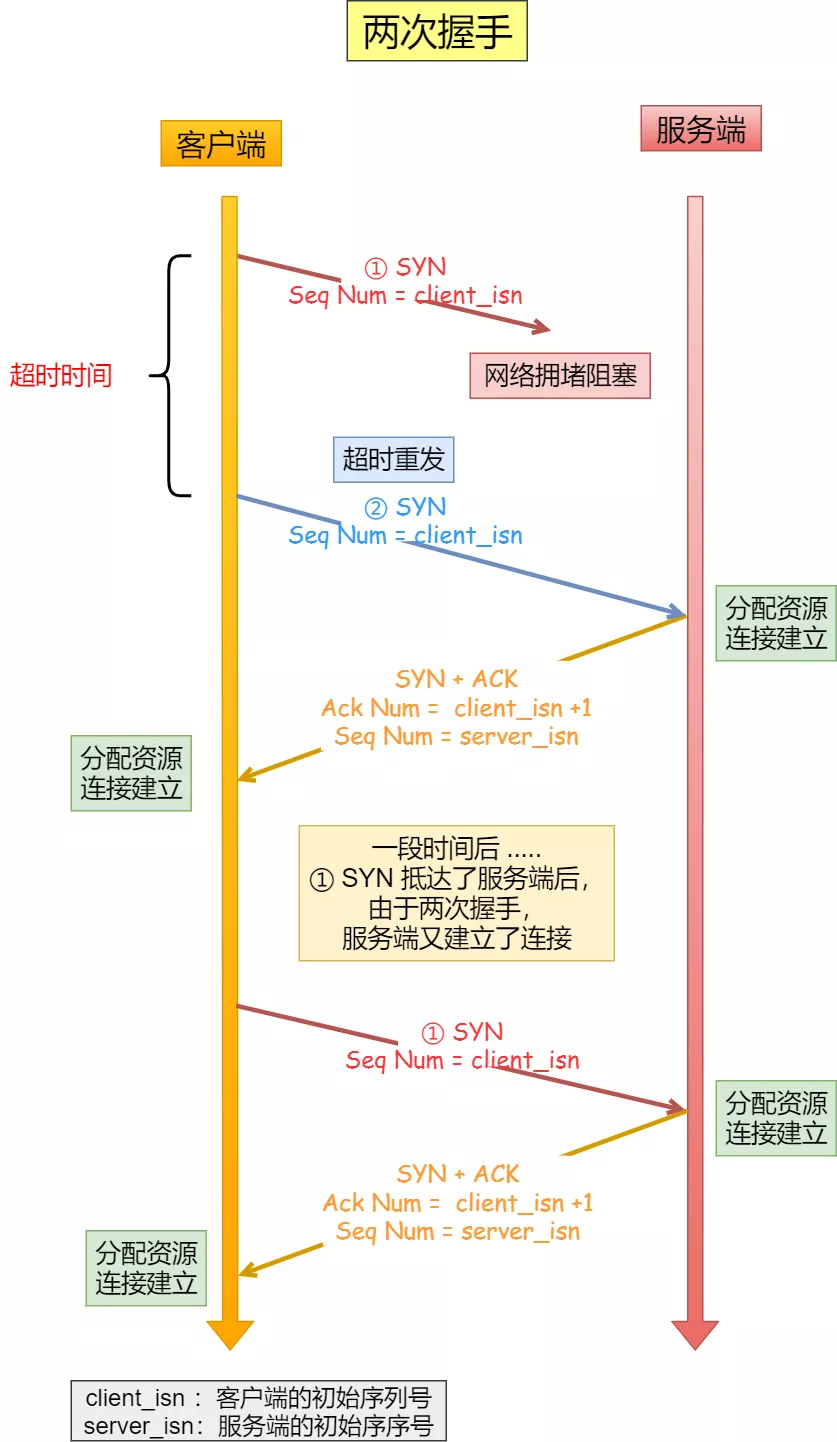
即两次握手会造成消息滞留情况下,服务器重复接受无用的连接请求 SYN 报文,而造成重复分配资源。
四次握手其实也能够可靠的同步双方的初始化序号,但由于第二步和第三步可以优化成一步,所以就成了「三次握手」。
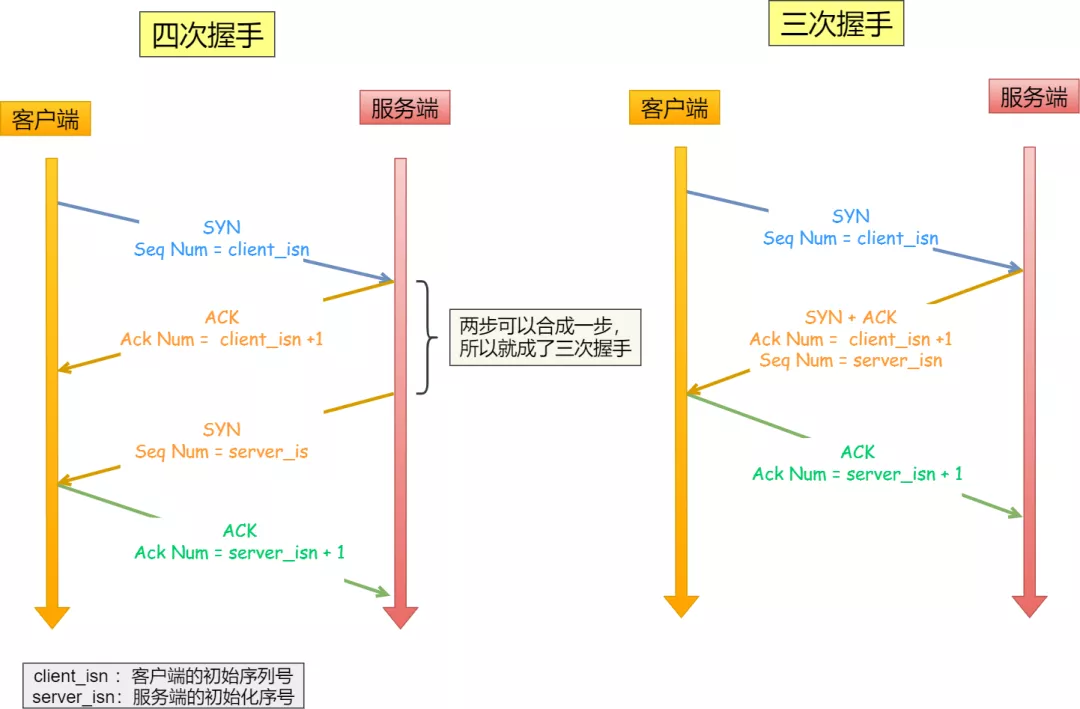
小结
TCP 建立连接时,通过三次握手 能防止历史连接的建立,能减少双方不必要的资源开销,能帮助双方同步初始化序列号。 序列号能够保证数据包不重复、不丢弃和按序传输。
不使用「两次握手」和「四次握手」的原因:
「两次握手」:无法防止历史连接的建立,会造成双方资源的浪费,也无法可靠的同步双方序列号;
「四次握手」:三次握手就已经理论上最少可靠连接建立,所以不需要使用更多的通信次数。
TCP 四次挥手过程和状态变迁
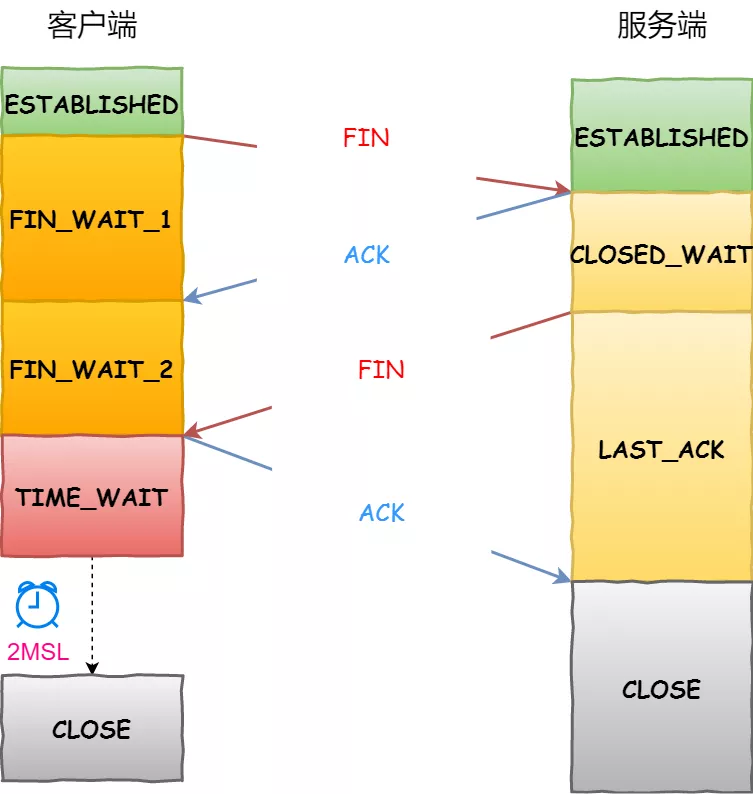
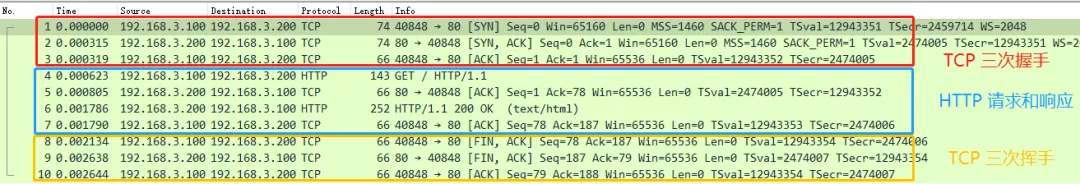
客户端打算关闭连接,此时会发送一个 TCP 首部 FIN 标志位被置为 1 的报文,也即 FIN 报文,之后客户端进入 FIN_WAIT_1 状态。
服务端收到该报文后,就向客户端发送 ACK 应答报文,接着服务端进入 CLOSED_WAIT 状态。
客户端收到服务端的 ACK 应答报文后,之后进入 FIN_WAIT_2 状态。
等待服务端处理完数据后,也向客户端发送 FIN 报文,之后服务端进入 LAST_ACK 状态。
客户端收到服务端的 FIN 报文后,回一个 ACK 应答报文,之后进入 TIME_WAIT 状态
服务器收到了 ACK 应答报文后,就进入了 CLOSE 状态,至此服务端已经完成连接的关闭。
客户端在经过 2MSL 一段时间后,自动进入 CLOSE 状态,至此客户端也完成连接的关闭。
你可以看到,每个方向都需要一个 FIN 和一个 ACK,因此通常被称为四次挥手。
这里一点需要注意是:主动关闭连接的,才有 TIME_WAIT 状态。
为什么挥手需要四次
再来回顾下四次挥手双方发 FIN 包的过程,就能理解为什么需要四次了。
关闭连接时,客户端向服务端发送 FIN 时,仅仅表示客户端不再发送数据了但是还能接收数据。
服务器收到客户端的 FIN 报文时,先回一个 ACK 应答报文,而服务端可能还有数据需要处理和发送,等服务端不再发送数据时,才发送 FIN 报文给客户端来表示同意现在关闭连接。
从上面过程可知,服务端通常需要等待完成数据的发送和处理,所以服务端的 ACK 和 FIN 一般都会分开发送,从而比三次握手导致多了一次。
服务端已经完成了数据的发送和处理,那么服务端的 ACK 和 FIN 会合并发送,变成三次挥手
为什么 TIME_WAIT 等待的时间是 2MSL
MSL 是 Maximum Segment Lifetime,报文最大生存时间,它是任何报文在网络上存在的最长时间,超过这个时间报文将被丢弃。因为 TCP 报文基于是 IP 协议的,而 IP 头中有一个 TTL 字段,是 IP 数据报可以经过的最大路由数,每经过一个处理他的路由器此值就减 1,当此值为 0 则数据报将被丢弃,同时发送 ICMP 报文通知源主机。
MSL 与 TTL 的区别:MSL 的单位是时间,而 TTL 是经过路由跳数。所以 MSL 应该要大于等于 TTL 消耗为 0 的时间,以确保报文已被自然消亡。
TIME_WAIT 等待 2 倍的 MSL,比较合理的解释是:网络中可能存在来自发送方的数据包,当这些发送方的数据包被接收方处理后又会向对方发送响应,所以一来一回需要等待 2 倍的时间。
比如,如果被动关闭方没有收到断开连接的最后的 ACK 报文,就会触发超时重发 Fin 报文,另一方接收到 FIN 后,会重发 ACK 给被动关闭方, 一来一去正好 2 个 MSL。
2MSL 的时间是从客户端接收到 FIN 后发送 ACK 开始计时的。如果在 TIME-WAIT 时间内,因为客户端的 ACK 没有传输到服务端,客户端又接收到了服务端重发的 FIN 报文,那么 2MSL 时间将重新计时。
在 Linux 系统里 2MSL 默认是 60 秒,那么一个 MSL 也就是 30 秒。Linux 系统停留在 TIME_WAIT 的时间为固定的 60 秒。
为什么需要 TIME_WAIT 状态
主动发起关闭连接的一方,才会有 TIME-WAIT 状态。
需要 TIME-WAIT 状态,主要是两个原因:
-
防止具有相同「四元组」的「旧」数据包被收到;
-
保证「被动关闭连接」的一方能被正确的关闭,即保证最后的 ACK 能让被动关闭方接收,从而帮助其正常关闭;
原因一:防止旧连接的数据包
假设 TIME-WAIT 没有等待时间或时间过短,被延迟的数据包抵达后会发生什么呢?
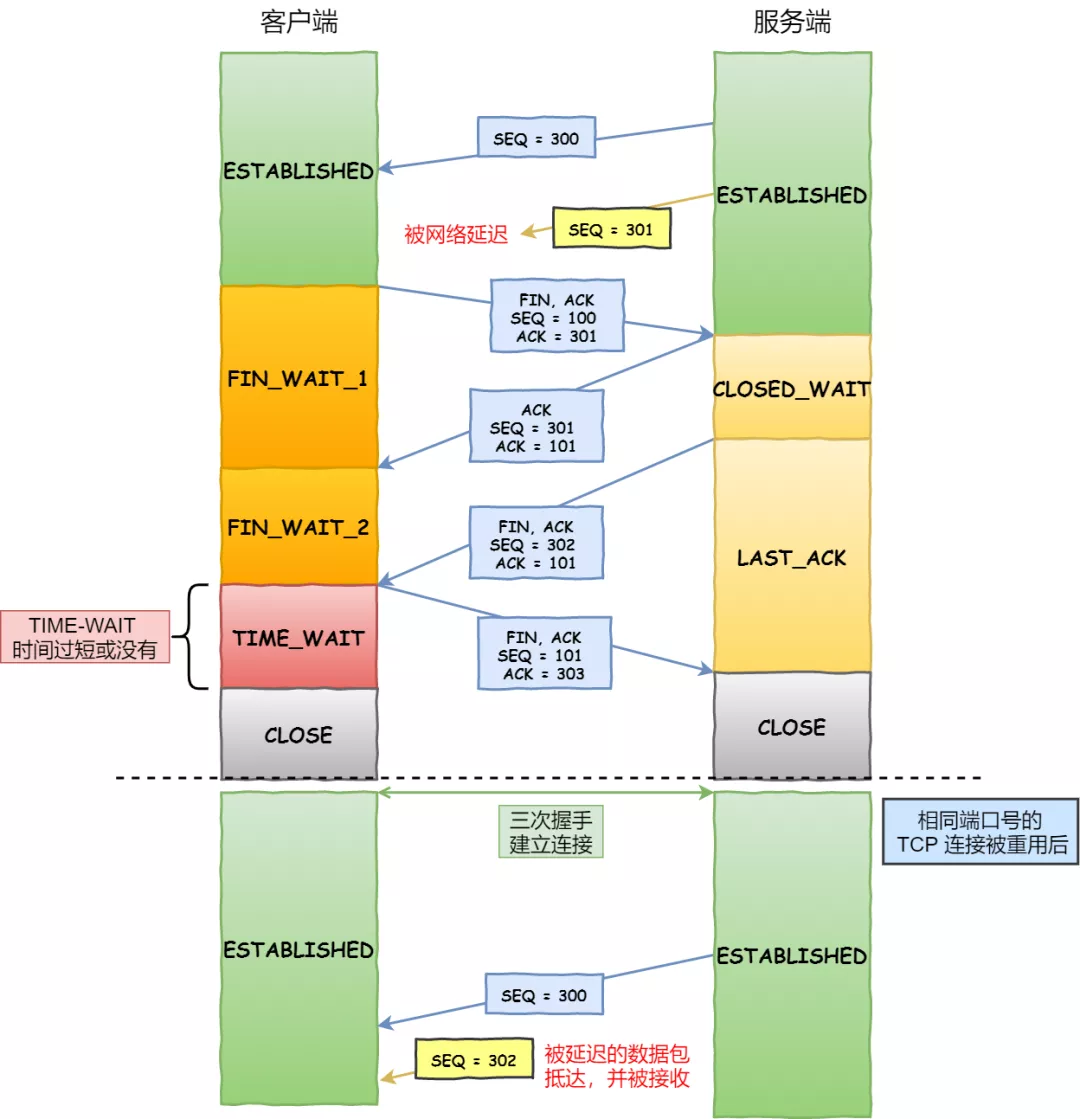
如上图黄色框框服务端在关闭连接之前发送的 SEQ = 301 报文,被网络延迟了。
这时有相同端口的 TCP 连接被复用后,被延迟的 SEQ = 301 抵达了客户端,那么客户端是有可能正常接收这个过期的报文,这就会产生数据错乱等严重的问题。
所以,TCP 就设计出了这么一个机制,经过 2MSL 这个时间,足以让两个方向上的数据包都被丢弃,使得原来连接的数据包在网络中都自然消失,再出现的数据包一定都是新建立连接所产生的。
原因二:保证连接正确关闭
在 RFC 793 指出 TIME-WAIT 另一个重要的作用是:
TIME-WAIT - represents waiting for enough time to pass to be sure the remote TCP received the acknowledgment of its connection termination request.
也就是说,TIME-WAIT 作用是等待足够的时间以确保最后的 ACK 能让被动关闭方接收,从而帮助其正常关闭。
假设 TIME-WAIT 没有等待时间或时间过短,断开连接会造成什么问题呢?
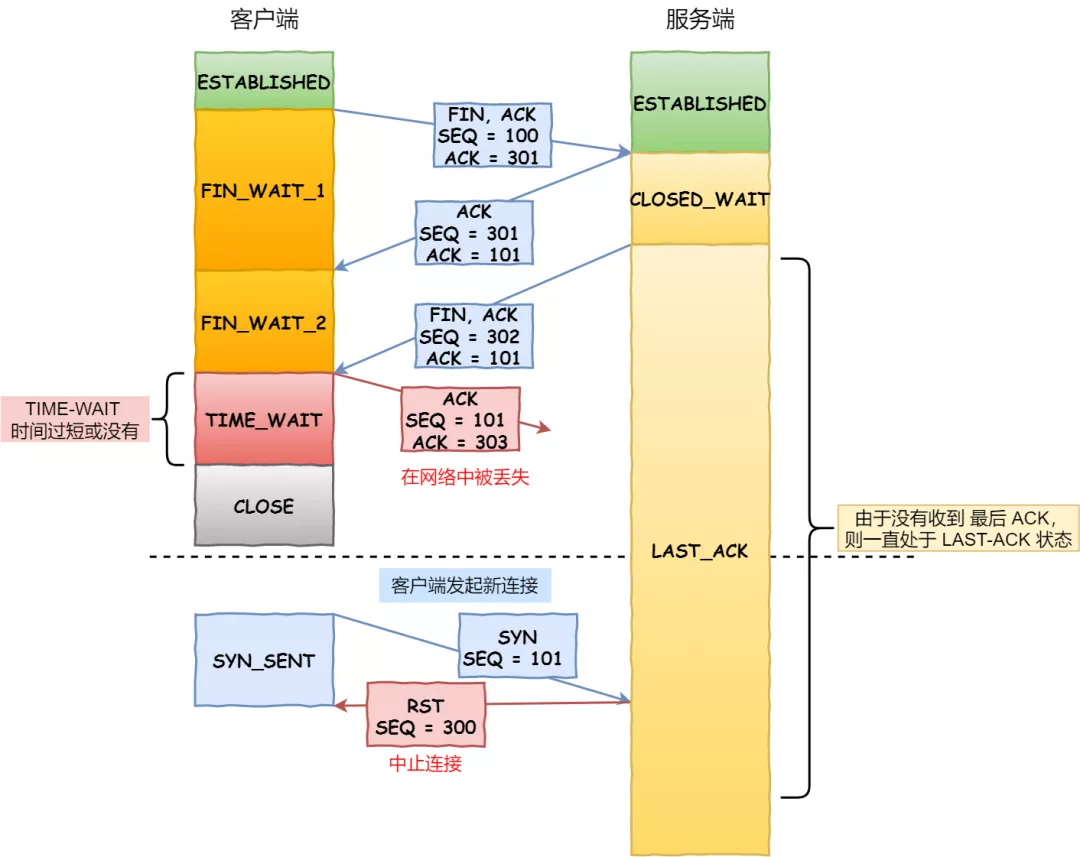
如上图红色框框客户端四次挥手的最后一个 ACK 报文如果在网络中被丢失了,此时如果客户端 TIME-WAIT 过短或没有,则就直接进入了 CLOSE 状态了,那么服务端则会一直处在 LASE-ACK 状态。
当客户端发起建立连接的 SYN 请求报文后,服务端会发送 RST 报文给客户端,连接建立的过程就会被终止。
如果 TIME-WAIT 等待足够长的情况就会遇到两种情况:
服务端正常收到四次挥手的最后一个 ACK 报文,则服务端正常关闭连接。
服务端没有收到四次挥手的最后一个 ACK 报文时,则会重发 FIN 关闭连接报文并等待新的 ACK 报文。
所以客户端在 TIME-WAIT 状态等待 2MSL 时间后,就可以保证双方的连接都可以正常的关闭。
TIME_WAIT 过多有什么危害
如果服务器有处于 TIME-WAIT 状态的 TCP,则说明是由服务器方主动发起的断开请求。
过多的 TIME-WAIT 状态主要的危害有两种:
第一是内存资源占用;
第二是对端口资源的占用,一个 TCP 连接至少消耗一个本地端口;
第二个危害是会造成严重的后果的,要知道,端口资源也是有限的,一般可以开启的端口为 32768~61000,也可以通过如下参数设置指定
net.ipv4.ip_local_port_range
服务端 TIME_WAIT 状态过多,占满了所有端口资源,则会导致无法创建新连接。
既然 IP 层会分片,为什么 TCP 层还需要 MSS ?
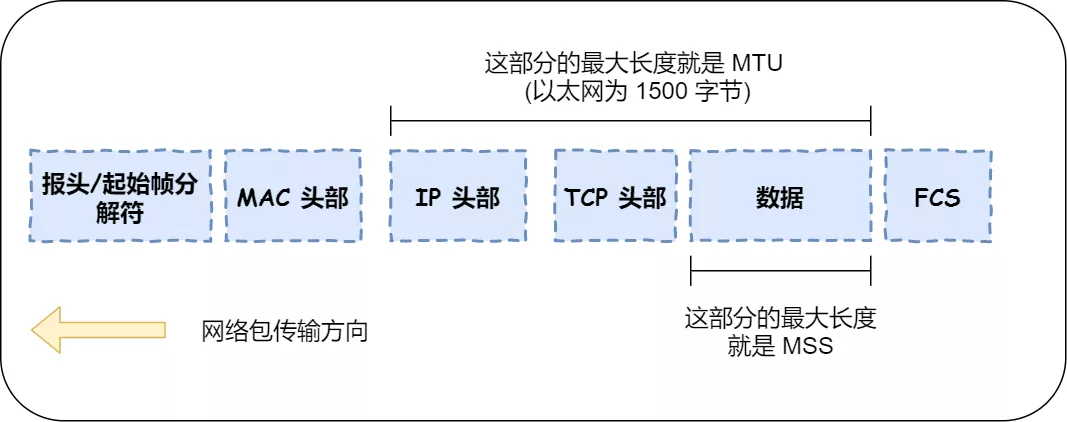
MTU:一个网络包的最大长度,以太网中一般为 1500 字节;
MSS:除去 IP 和 TCP 头部之后,一个网络包所能容纳的 TCP 数据的最大长度;
如果TCP 的整个报文(头部 + 数据)交给 IP 层进行分片,会有什么异常呢?
当 IP 层有一个超过 MTU 大小的数据(TCP 头部 + TCP 数据)要发送,那么 IP 层就要进行分片,把数据分片成若干片,保证每一个分片都小于 MTU。把一份 IP 数据报进行分片以后,由目标主机的 IP 层来进行重新组装后,在交给上一层 TCP 传输层。
这看起来井然有序,但这存在隐患的,那么当如果一个 IP 分片丢失,整个 IP 报文的所有分片都得重传。
因为 IP 层本身没有超时重传机制,它由传输层的 TCP 来负责超时和重传。
当接收方发现 TCP 报文(头部 + 数据)的某一片丢失后,则不会响应 ACK 给对方,那么发送方的 TCP 在超时后,就会重发「整个 TCP 报文(头部 + 数据)」。
因此,可以得知由 IP 层进行分片传输,是非常没有效率的。
所以,为了达到最佳的传输效能 TCP 协议在 建立连接的时候通常要协商双方的 MSS 值 ,当 TCP 层发现数据超过 MSS 时,则就先会进行分片,当然由它形成的 IP 包的长度也就不会大于 MTU ,自然也就不用 IP 分片了。
经过 TCP 层分片后,如果一个 TCP 分片丢失后,进行重发时也是以 MSS 为单位,而不用重传所有的分片,大大增加了重传的效率。
参考
硬不硬你说了算!近 40 张图解被问千百遍的 TCP 三次握手和四次挥手面试题
你还在为 TCP 重传、滑动窗口、流量控制、拥塞控制发愁吗?看完图解就不愁了